خرید آنلاین و حضوری با اسنپ‌پی
در حال بارگذاری…
شبکه اطلاع رسانی طـــــــــــلا، ســکـــــــــــه و ارز
کیان
اولین گوشی برند استارلایت هواوی نمایشگر عریض خواهد داشت

اولین گوشی برند استارلایت هواوی نمایشگر عریض خواهد داشت

تحلیل ترون امروز ۸ آبان: نوسان در محدودهٔ ۰.۳۴ دلار و سناریوهای صعودی

تحلیل ترون امروز ۸ آبان: نوسان در محدودهٔ ۰.۳۴ دلار و سناریوهای صعودی

صرافی بایننس هک شد | مسدودشدن حدود ۲ میلیارد دلار دارایی (۸ آبان ۱۴۰۵)

صرافی بایننس هک شد | مسدودشدن حدود ۲ میلیارد دلار دارایی (۸ آبان ۱۴۰۵)

دوربین نظارتی جدید شیائومی با سیم‌کارت داخلی و اینترنت رایگان رونمایی شد

دوربین نظارتی جدید شیائومی با سیم‌کارت داخلی و اینترنت رایگان رونمایی شد

دوربین جدید شیائومی سیم‌کارت اختصاصی با اینترنت رایگان دارد

دوربین جدید شیائومی سیم‌کارت اختصاصی با اینترنت رایگان دارد

افت ۱۳ درصدی سهام آلفابت؛ بازار نگران هزینه‌های هوش مصنوعی گوگل است

افت ۱۳ درصدی سهام آلفابت؛ بازار نگران هزینه‌های هوش مصنوعی گوگل است

چرا سهام شرکت مادر گوگل سقوط کرد؟

چرا سهام شرکت مادر گوگل سقوط کرد؟

آموزش کپی کردن فایل بین کانتینر داکر و سیستم میزبان با دستور docker container cp

آموزش کپی کردن فایل بین کانتینر داکر و سیستم میزبان با دستور docker container cp

قابلیت‌های جدید Siri AI با پشتیبانی از زبان‌های تازه؛ درک صفحه و سقف استفاده ابری

قابلیت‌های جدید Siri AI با پشتیبانی از زبان‌های تازه؛ درک صفحه و سقف استفاده ابری

بازی Phantom Blade Zero به جی‌فورس ناو آمد؛ پشتیبانی از ماد در سایبرپانک و ویچر ۳

بازی Phantom Blade Zero به جی‌فورس ناو آمد؛ پشتیبانی از ماد در سایبرپانک و ویچر ۳

فراتر از متن و تصویر؛ مدل هوش مصنوعی AudioX مرزهای تولید صدا را جابه‌جا می‌کند

بازدید ۶منبع: زومیت
فراتر از متن و تصویر؛ مدل هوش مصنوعی AudioX مرزهای تولید صدا را جابه‌جا می‌کند

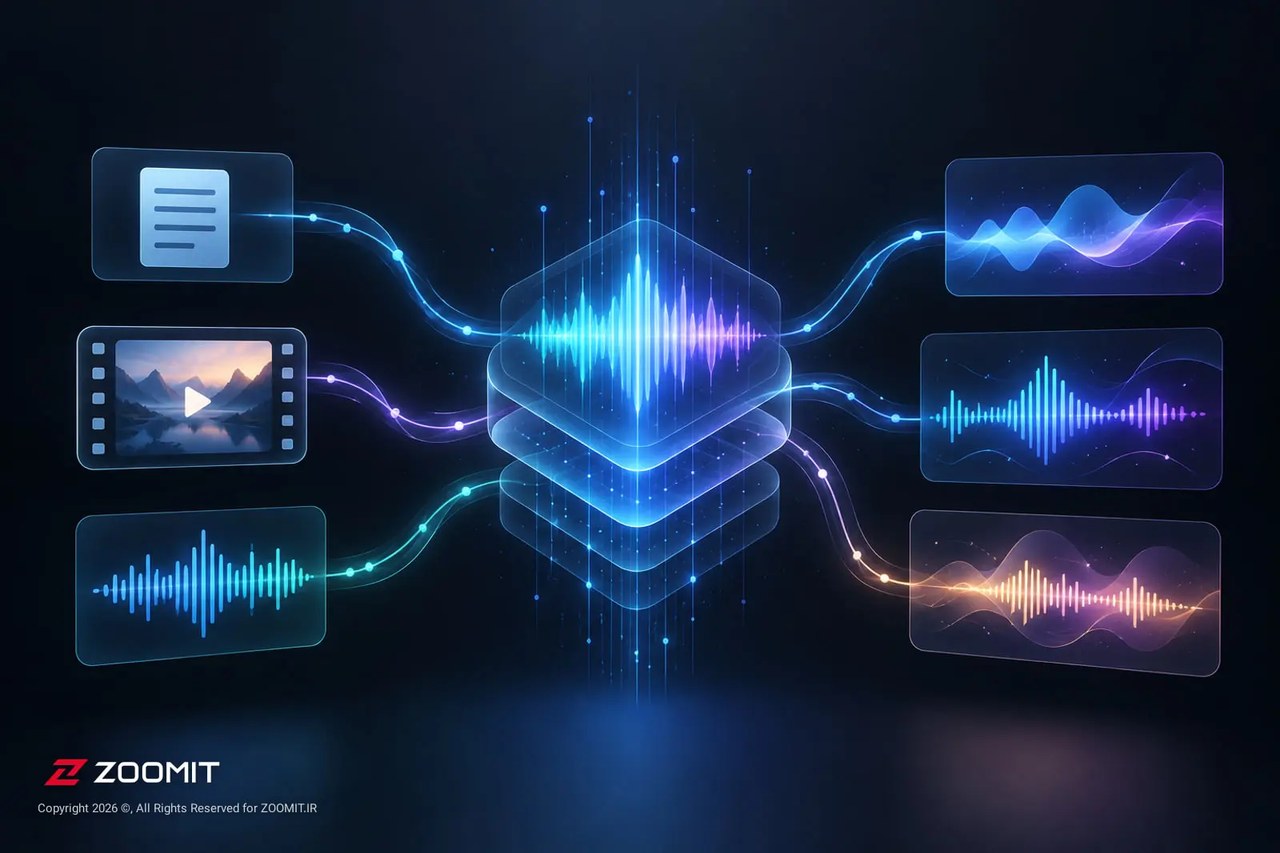
پژوهشگران حوزه‌ی هوش مصنوعی چارچوب چندوجهی جدیدی را برای تولید صدا و موسیقی از متن، ویدیو و فایل‌های صوتی معرفی کردند.

پژوهشگران حوزه‌ی هوش مصنوعی چارچوب چندوجهی جدیدی را برای تولید صدا و موسیقی از متن، ویدیو و فایل‌های صوتی معرفی کردند.

محققان هوش مصنوعی چارچوب یکپارچه‌ی نوینی به نام AudioX توسعه داده‌اند که توانایی تولید صدا و موسیقی را از ورودی‌های گوناگون نظیر متن، ویدیو و سیگنال‌های صوتی در یک سامانه‌ی واحد فراهم می‌کند.

توسعه‌دهندگان در این پروژه ماژول جدیدی با عنوان ادغام تطبیقی چندوجهی یا MAF طراحی کرده‌اند تا ترکیب ورودی‌های نامتجانس را بهبود بخشند و هماهنگی میان‌وجهی دقیق‌تری ایجاد کنند. پژوهشگران برای آموزش این مدل، دیتاست‌های جامعی متشکل از بیش از ۷ میلیون نمونه موسوم به IF-caps گردآوری و منتشر کرده‌اند.

پروژه‌ی مذکور در پلتفرم هاگینگ فیس در قالب سه نسخه‌ی مجزا شامل مدل پایه‌ی AudioX، نسخه‌ی مجهز به ماژول تلفیق AudioX-MAF و نسخه‌ی پیشرفته‌تر AudioX-MAF-MMDiT منتشر شده است. ارزیابی‌های اولیه از عملکرد قدرتمند این ساختار در وظایف متن به صدا، متن به موسیقی و همچنین پیروی از دستورهای پیچیده حکایت دارد.

دسترسی به کدهای منبع، وزن‌های مدل و دموی تعاملی برای پژوهشگران مهیا است. اجرای آفلاین این مدل به محیط پایتون نسخه‌ی ۳٫۸ و بالاتر به‌همراه ابزارهایی نظیر FFmpeg و کارت گرافیک سازگار با محاسبات هوش مصنوعی نیاز دارد.

منبع: زومیت
اشتراک‌گذاری:

نظرات کاربران

هنوز نظری برای این مطلب ثبت نشده — اولین نفر باشید.