


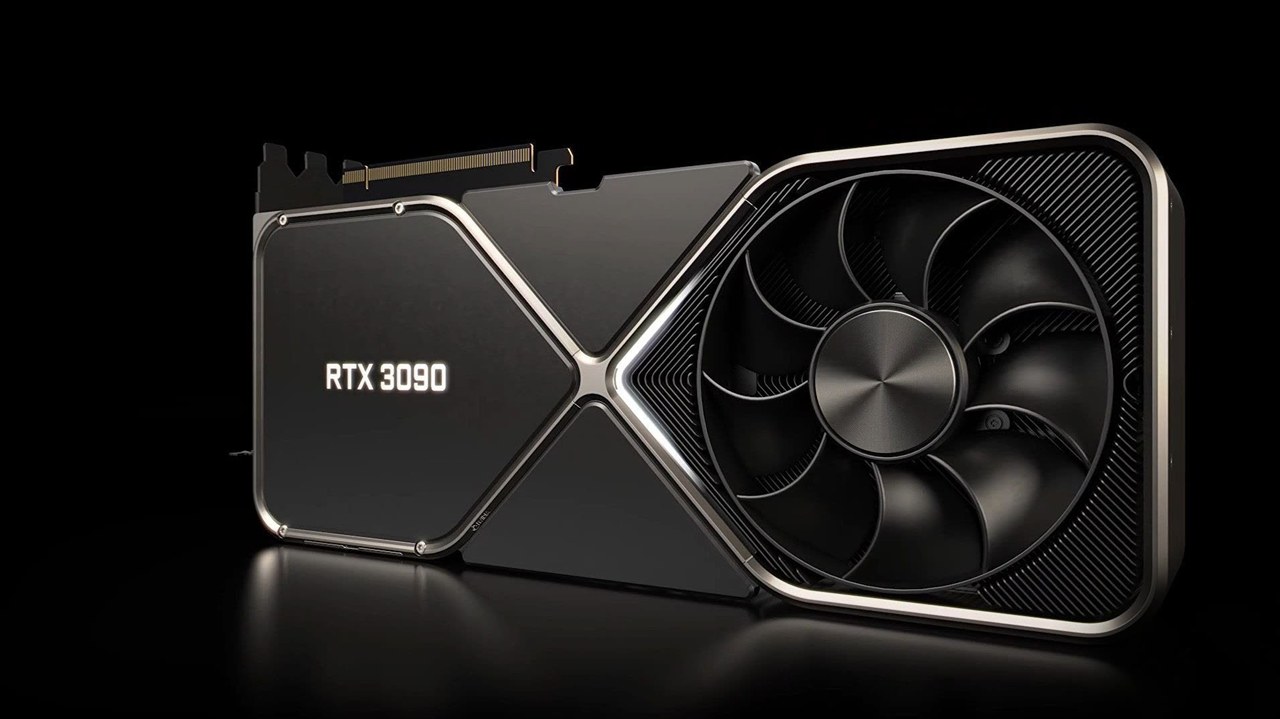
کارت گرافیک دستدوم RTX 3090 به گزینهای محبوب برای اجرای مدلهای هوش مصنوعی در خانه تبدیل شده است. دلیل اصلی این محبوبیت، حافظه ۲۴ گیگابایتی آن با قیمتی بسیار کمتر از کارتهای مخصوص ایستگاههای کاری است.
با وجود این مزیت، محدودیتی در مشخصات رسمی انویدیا وجود دارد که سرعت اجرای یکی از رایجترین انواع محاسبات هوش مصنوعی را در کارتهای جیفورس به نصف کاهش میدهد. اکنون چند پروژه متنباز مدعی شدهاند که این محدودیت را در کارتهای سری RTX 20، 30 و ۴۰ برطرف میکنند.
این محدودیت به هستههای تنسور مربوط میشود. هنگامی که این هستهها اعداد FP16 یا BF16 را در یکدیگر ضرب میکنند و نتایج را با دقت بالاتر FP32 جمع میزنند، سرعت اجرای این دستورها در کارتهای جیفورس به نصف حالت FP16 با انباشت نتایج میرسد. بسیاری از فرایندهای آموزش مدلهای هوش مصنوعی و بخش قابلتوجهی از استنتاج نیز به همین حالت FP32 متکی هستند. در مقابل، کارتهای مخصوص ایستگاه کاری انویدیا که از تراشههای مشابه بهره میبرند، مانند RTX A6000، این محاسبات را با سرعت کامل انجام میدهند.
روش آزاد کردن محدودیت و نتایج آزمایشها
نخستین راهکار را کاربری با نام زاگیتا در گیتهاب ارائه داد. او پروژهای به نام GPU Unlock را برای کارتهای سری RTX 30 منتشر کرد. این ابزار یک ماژول هسته لینوکس است که پیش از بارگذاری درایور انویدیا اجرا میشود. ماژول در این مرحله دو ثبات انتخاب سرعت را در پردازنده گرافیکی تغییر میدهد و سپس کارت را راهاندازی مجدد میکند. پس از آن، درایور معمول انویدیا بدون تغییر به کار خود ادامه میدهد؛ بنابراین نیازی به فلشکردن بایوس کارت گرافیک یا دستکاری درایور وجود ندارد.
آزمایشهای توسعهدهنده روی RTX 3090 Ti با محدودیت توان ۴۵۰ وات نشان میدهد که توان پردازش BF16 در عملیات ضرب ماتریسی از ۸۷.۵ به ۱۵۷.۴ ترافلاپس افزایش یافته. عملکرد TF32 نیز تقریباً دو برابر شده و سرعت FP16 رشد کمتری، معادل ۳۵ درصد، داشته است.
پس از انتشار این ابزار، توسعهدهندگان دیگر نسخههایی برای دو نسل باقیمانده از کارتهای گرافیک انویدیا آماده کردند. نسخهای با نام GPU Unlock Ada توانست نرخ اجرای دستورهای FP16 در RTX 4090 را از ۱۶۵.۶ به ۳۳۱.۶ ترافلاپس افزایش دهد. البته این اعداد صرفاً نرخ خام اجرای دستورها را نشان میدهند؛ موضوعی که در توضیحات پروژه نیز به آن اشاره شده است. آزمایشهای یک مالک مستقل روی بارهای کاری واقعی ماتریسی، افزایش عملکرد کمتری در محدوده ۱۲ تا ۳۴ درصد را نشان داد.
در نسل قدیمیتر، پروژه Turing Unlock کارت RTX 2080 Ti را هدف قرار میدهد. این ابزار روی یکی از کارتهای تغییریافته با حافظه ویدئویی ۲۲ گیگابایتی آزمایش شده که میان کاربران با بودجه محدود برای ساخت سیستمهای هوش مصنوعی محبوبیت دارد. توسعهدهنده این پروژه، بسته به ابعاد ماتریس، افزایش سرعتی بین ۳۶ تا ۶۴ درصد را در محاسبات ماتریسی FP16 اندازهگیری کرده است. محاسبات BF16 در این کارت پشتیبانی نمیشوند، زیرا معماری تورینگ از ابتدا سختافزار لازم برای اجرای آنها را نداشت.
تأثیر بر بازیها و برنامههای هوش مصنوعی
گیمرها احتمالاً تفاوت محسوسی احساس نخواهند کرد، زیرا بازیها بهندرت از این نوع محاسبات استفاده میکنند. سرعت تولید توکن در چتباتها نیز تغییر چندانی ندارد؛ زیرا تولید متن بیشتر به پهنای باند حافظه وابسته است تا توان پردازشی خام. با این وجود، پردازش اولیه درخواستها میتواند طبق گزارشها بین ۱۴ تا ۳۶ درصد سریعتر انجام شود. تولید تصویر و ریزتنظیم مدلهای هوش مصنوعی بیشترین بهره را از این تغییر میبرند، چرا که هر دو بهشدت از محاسبات تنسوری FP32 با انباشت نتایج استفاده میکنند.
در حال حاضر، پشتیبانی از این ابزارها عمدتاً به سیستمعامل لینوکس محدود میشود. البته چند نسخه آزمایشی برای ویندوز نیز توسعه یافتهاند که اعتبارسنجی آنها فقط روی سختافزارهای مشخصی انجام گرفته است.
زاگیتا احتمال آسیبدیدن سختافزار را بسیار پایین میداند و اشاره میکند که سازوکارهای معمول محدودسازی عملکرد و مدیریت توان کارت گرافیک همچنان فعال باقی میمانند. در مقابل، توضیحات پروژه Turing Unlock محتاطانهتر است و هشدار میدهد که هستههای تنسور مصرف برق بالایی دارند و استفاده مداوم از آنها با حداکثر توان ممکن است به سختافزار آسیب برساند.




نظرات کاربران